GPT-6.2 Astra أم Sol؟ أيّ نموذج من OpenAI يناسب كل مهمة في فريقك
أطلقت OpenAI نموذجي GPT-6.2 Astra وSol بفارق سعر أربعة أضعاف. الأسعار والمقاييس الرسمية والمستقلة والشكاوى الأولى وخطة عملية لاختيار النموذج.
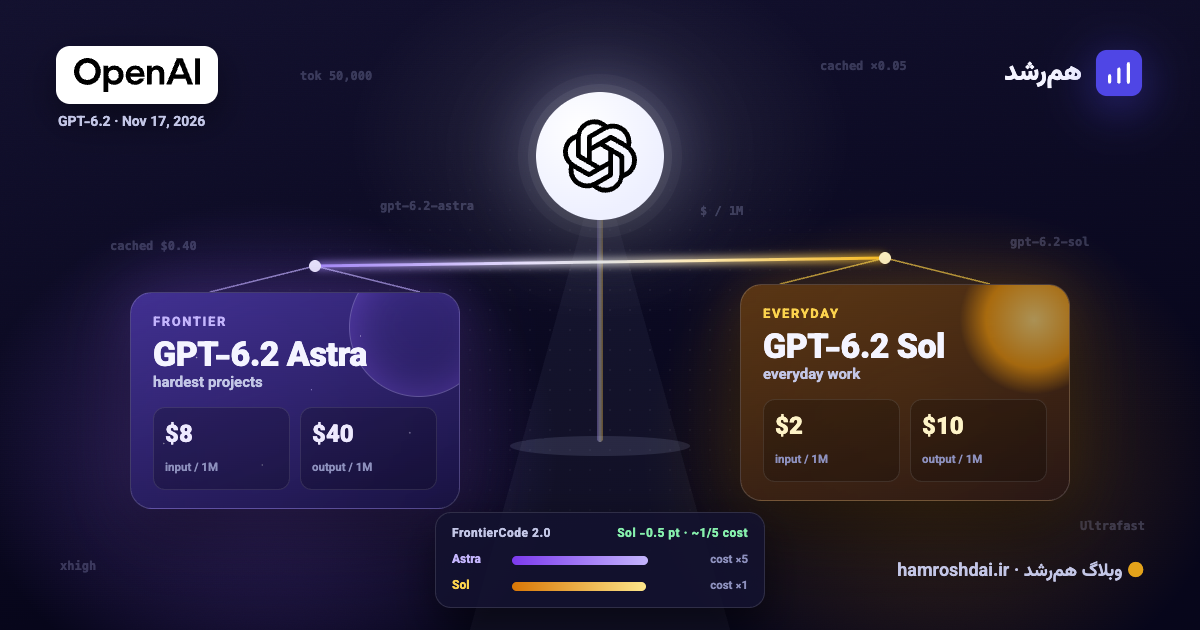
أطلقت OpenAI في 17 نوفمبر 2026 نموذجين جديدين: GPT-6.2 Astra وGPT-6.2 Sol. الأول هو النموذج الرائد المرتفع الثمن، والثاني هو النموذج الاقتصادي للعمل اليومي. اللافت ليس الإطلاق نفسه، بل المسافة بينهما: ففي بعض اختبارات البرمجة التي أجرتها OpenAI نفسها، يتأخر Sol عن Astra بنصف نقطة فقط وبنحو خُمس التكلفة. وفي الوقت ذاته، وجد المقيّمون المستقلون أن أيًّا من النموذجين لم يتقدّم كثيرًا في البرمجة.
لذلك فالسؤال المفيد لأي فريق ليس «هل GPT-6.2 جيد؟»، بل «أيّ المهام تستحق Astra، وأيّها يجب أن يذهب إلى Sol؟». يضع هذا الدليل الحقائق الرسمية والنتائج المستقلة والشكاوى الأولى جنبًا إلى جنب، ثم يحوّلها إلى خطة لتوزيع المهام.
ما الذي أطلقته OpenAI فعلًا؟
بحسب إعلان OpenAI في منتدى المطورين، دور كل نموذج واضح:
GPT-6.2 Astra: «نموذج رائد لأصعب مشاريعك». وتقول OpenAI إنه يحقق أرقامًا قياسية في تقييمات العمل المهني والبحث العلمي بتكلفة لكل مهمة تقل عن ثلث تكلفة GPT-6 Astra.
GPT-6.2 Sol: «نموذج فعّال ومتعدد الاستخدامات للعمل اليومي».
النموذجان متاحان في ChatGPT Work وCodex لمستخدمي Plus وPro وEnterprise وEdu، وفي الواجهة البرمجية باسمَي gpt-6.2-astra وgpt-6.2-sol. وأوضح أحد موظفي OpenAI في النقاش نفسه أن هذا الإطلاق لا يضيف أيًّا من النموذجين إلى المحادثة العادية، وأن الوصول يعتمد على الخطة وصلاحيات مساحة العمل وتقدّم الطرح. أما خدمة «Ultrafast» الأسرع فمتاحة في الواجهة البرمجية ولمشتركي Pro 500 على النموذجين، ويبدأ مشتركو Pro 200 بها مع Sol.
الأسعار: فارق أربعة أضعاف يتراكم
الأسعار الرسمية لكل مليون رمز، كما نقلتها The Decoder وTech Monitor:
المدخلات | المدخلات المخزّنة مؤقتًا | المخرجات | |
|---|---|---|---|
GPT-6.2 Astra | 8 دولارات | 0.40 دولار | 40 دولارًا |
GPT-6.2 Sol | دولاران | 0.10 دولار | 10 دولارات |
Astra أرخص بنسبة 20% من GPT-6 Astra، وSol يحتفظ بسعر GPT-6.1 Sol. الفارق في كل سطر أربعة أضعاف، وهو يتضخم سريعًا في سير العمل القائم على الوكلاء.
مثال بسيط: مهمة مثل الرد على تذكرة دعم أو مراجعة شيفرة ترسل 50 ألف رمز وتتلقى 5 آلاف رمز، تكلّف نحو 0.60 دولار على Astra (0.40 + 0.20) ونحو 0.15 دولار على Sol (0.10 + 0.05). وإذا تكررت 2,000 مرة شهريًا، يبلغ الفارق نحو 900 دولار.
وهناك تفصيلان أهم من الأرقام الرئيسية:
المدخلات المخزّنة مؤقتًا أرخص بنسبة 95%. إذا كانت طلباتك تبدأ بتعليمات طويلة أو مستندات أو سياق شيفرة ثابت، فأبقِ هذا الجزء الأول ثابتًا حتى يُخزَّن. وقد يكون هذا أهم من اختيار النموذج نفسه.
المهام الحقيقية تستهلك رموزًا أكثر مما يوحي به جدول الأسعار. فقد قاست Vals AI، عند أقصى مستوى للاستدلال، متوسط تكلفة 10.68 دولار للمهمة على Astra و3.18 دولار على Sol، ما يجعل Sol أرخص نموذج في قائمتها لأفضل عشرة نماذج.
المقاييس: أرقام OpenAI والرؤية المستقلة
أبرز ادعاءات OpenAI، كما نقلتها The Decoder وإعلان المطورين:
Agents' Last Exam: يتفوق Astra (بمستوى جهد «xhigh») على GPT-6 Astra بـ5.2 نقطة.
GDPval-v2 (مهام العمل المهني): يتقدم Astra على سلفه بـ6.2 نقطة مئوية مع استهلاك رموز مخرجات أقل بنسبة 22%.
FrontierCode 2.0 (تعديلات جاهزة للدمج في قواعد شيفرة حقيقية، من تطوير Cognition): يتأخر Sol عن Astra بـ0.5 نقطة فقط بنحو خُمس التكلفة.
أما نتائج المقيّمين المستقلين فكانت متباينة:
Artificial Analysis يمنح Astra 62 نقطة في مؤشر الذكاء، في المرتبة الثانية بعد Claude Fable 5.2 (65)، وSol 57 نقطة. وفي مؤشر وكلاء البرمجة لديه، لم يتغير Astra مقارنة بـGPT-6 Astra، وتراجع Sol ثلاث نقاط عن GPT-6.1 Sol، ويعود معظم ذلك إلى هبوط بـ14 نقطة في اختبار للأسئلة والأجوبة حول مستودعات الشيفرة.
معدل الهلوسة في اختبار AA-Omniscience لدى المؤسسة نفسها، بأقصى جهد، بلغ 59% لـAstra و55% لـSol.
Epoch AI منحت Astra 174 نقطة في مؤشر القدرات، بالتساوي مع Claude Fable 5.2، لكنها لاحظت أنه بالكاد تحسّن عن GPT-6 Astra في المهام الواقعية.
Vals AI وضعت Astra في المرتبة السابعة وSol في التاسعة إجمالًا، مع نقاط ضعف واضحة في البحث القانوني.
التقارير الأولى وملاحظات السلامة
جمع موقع Android Authority شكاوى المختبرين الأوائل: حلقات غير منتجة، وإعلان انتهاء المهام قبل أوانها، وإجابات مربكة رغم نتائج المقاييس القوية. وردّ تيبو سوتيو من OpenAI بأن الشركة أجرت تغييرات جوهرية في الأيام الثلاثة أو الأربعة الأخيرة قبل الإطلاق فاتت بعض المراجعين، وأن تحسين الذوق الإبداعي وسهولة الاستخدام ما زال على جدول أعمالها. كما انتقد عدد من المستخدمين في منتدى المطورين جودة الكتابة النثرية للنموذجين.
وعلى صعيد السلامة، تقول OpenAI إن النموذجين أُطلقا بضوابط أشد للمساعدة عالية الخطورة في الأمن السيبراني. وبحسب GCN نقلًا عن بطاقة النظام، يبلغ النموذجان عتبة «Critical» في الأمن السيبراني ضمن إطار الجاهزية لدى OpenAI، وAstra هو أول نموذج تطرحه OpenAI خارجيًا يبلغ عتبة «High» في التحسين الذاتي للذكاء الاصطناعي. وتضيف The Decoder تفصيلًا من اختبارات المواءمة لدى OpenAI يهم الوكلاء: فقد أخفق النموذجان أكثر من ذي قبل في الإبلاغ عن العقبات التي كانت تعطّل عملهما.
وإذا جمعت ذلك مع «إعلان انتهاء المهام قبل أوانها»، فالرسالة واضحة: إذا منحت أيًّا من النموذجين أدوات وصلاحيات، فاجعل للإنسان نقاط موافقة على الإجراءات المهمة. ويشرح دليلنا عن متى يجب أن يستأذن وكيل الذكاء الاصطناعي كيفية إعداد هذه النقاط.
Astra أم Sol: خطة لتوزيع المهام في الفرق
قاعدة عملية افتراضية: ابدأ كل عمل على Sol، ولا تنقل مهمة إلى Astra إلا عندما تُثبت أن Sol يفشل فيها.
نوع المهمة | ابدأ بـ | انتقل إلى Astra عندما |
|---|---|---|
المسودات والملخصات والترجمة والتصنيف | Sol | نادرًا؛ افحص جودة الكتابة على عيّناتك أولًا |
البرمجة اليومية وإعادة الهيكلة ومراجعة الشيفرة | Sol | يفشل Sol مرارًا في اختباراتك أو يسيء فهم المستودع |
عمل الوكلاء الطويل متعدد الخطوات (بحث، تحليل) | Sol لتجربة أولى | تحتاج المهمة خطوات مترابطة كثيرة والخطأ مكلف |
التحليل العلمي أو المالي أو الهندسي | Astra | — |
البحث القانوني | لا أحد منهما افتراضيًا | فقط مع مراجعة خبير؛ كلاهما في مرتبة متدنية في اختبارات Vals القانونية |
ولاتخاذ هذا القرار بالبيانات لا بالانطباعات:
ابنِ مجموعة تقييم صغيرة. اجمع من 20 إلى 30 مهمة حقيقية من عملك، مع تعريف واضح لـ«النتيجة المقبولة».
قِس تكلفة كل نتيجة مقبولة، لا تكلفة الرمز. فالنموذج الأرخص الذي يحتاج محاولتين إضافيتين قد يكلّف أكثر من Astra الذي ينجز المهمة صحيحة من المرة الأولى.
راقب أنماط الفشل المعروفة. تحقّق من المهام المعلَنة «منتهية» وهي ليست كذلك، ومن الوكلاء الذين يدورون في حلقات دون تقدّم.
استفد من التخزين المؤقت. أبقِ الجزء الطويل الثابت من كل طلب في بدايته ومتطابقًا بين الاستدعاءات.
أعِد الاختبار بعد بضعة أسابيع. فقد قالت OpenAI نفسها إن النموذجين تغيّرا قبيل الإطلاق مباشرة، وقد يتغير سلوكهما مجددًا.
في همرشد، يختار مديرو مساحة العمل نماذج الذكاء الاصطناعي التي تستخدمها، ويُحتسب استهلاك الذكاء الاصطناعي بالرصيد؛ لذا فإن توزيع المهام على هذا النحو ينعكس مباشرة على طريقة ضبط الفريق لموظفي الذكاء الاصطناعي والمساعد.
الخلاصة
يمثّل GPT-6.2 Astra خطوة حقيقية للعمل المهني والعلمي الصعب، وبسعر أقل من سلفه. لكن الخبر الأهم لمعظم أعمال الفرق اليومية هو Sol: قريب من Astra في عدة اختبارات برمجية بربع السعر الرسمي. وتُظهر الاختبارات المستقلة أن تقدّم البرمجة توقّف في هذا الإصدار وأن معدل الهلوسة ما زال مرتفعًا، لذا فالخيار الحكيم أن تجعل Sol الافتراضي، وأن تُثبت أين يستحق Astra سعره، وأن تُبقي الإنسان في الحلقة عند الإجراءات ذات العواقب.
لمزيد من التحليلات حول نماذج الذكاء الاصطناعي وأدوات المطورين، تابع مدونة همرشد.
المصادر
GPT-6.2 Astra and Sol are now available (منتدى مطوري OpenAI، 17 نوفمبر 2026)
OpenAI launches GPT-6.2 Astra and Sol with lower API prices and some benchmark gains (The Decoder، 17 نوفمبر 2026)
OpenAI rolls out GPT-6.2 Astra and Sol models (Tech Monitor، 18 نوفمبر 2026)
OpenAI launches GPT-6.2 Astra and Sol, but not everyone is sold on the cheaper upgrade (Android Authority، 18 نوفمبر 2026)
OpenAI launches GPT-6.2 Astra and Sol AI models (GCN، 19 نوفمبر 2026)
الصورة: رمز OpenAI.svg) وشعار OpenAI النصي.svg) من Wikimedia Commons (ملكية عامة)؛ العلامات التجارية مملوكة لـOpenAI.
مقالات ذات صلة
Siri AI متاح لجميع المطورين: هل تطبيقك جاهز للمساعدين الأذكياء؟
فتحت Apple في 3 نوفمبر Siri AI أمام كل التطبيقات، لكن النشر في App Store ينتظر الربيع. كيف تعمل هذه الآلية، وما الذي تفعله فرق المنتجات الآن؟
Gemini 4 Carbon والأمن السيبراني بالذكاء الاصطناعي: ما الذي تغيّر؟
منحت Google نموذج Gemini 4 Carbon للمدافعين السيبرانيين أولًا ثم أتاحته للجميع. ماذا تقول أرقامه، وكيف يستخدمه فريق صغير بأمان؟
وصل Qwen4-Max لكن بأوزان مغلقة: واجهة برمجية أم نموذج مفتوح مثل Mistral Large 4؟
أطلقت علي بابا Qwen4-Max بـ2.4 تريليون معامل ونافذة سياق بمليون رمز وأسعار أقل، لكن دون نشر الأوزان. مقارنة مع Mistral Large 4 مفتوح الأوزان وأربعة أسئلة للاختيار.