GPT-6.2 Astra یا Sol؛ کدام کار تیم را به کدام مدل تازهٔ OpenAI بسپاریم؟
OpenAI دو مدل GPT-6.2 Astra و Sol را با فاصلهٔ قیمت ۴ برابری عرضه کرد. قیمتها، بنچمارکهای رسمی و مستقل، گلایههای اولیه و یک نقشهٔ عملی برای انتخاب مدل.
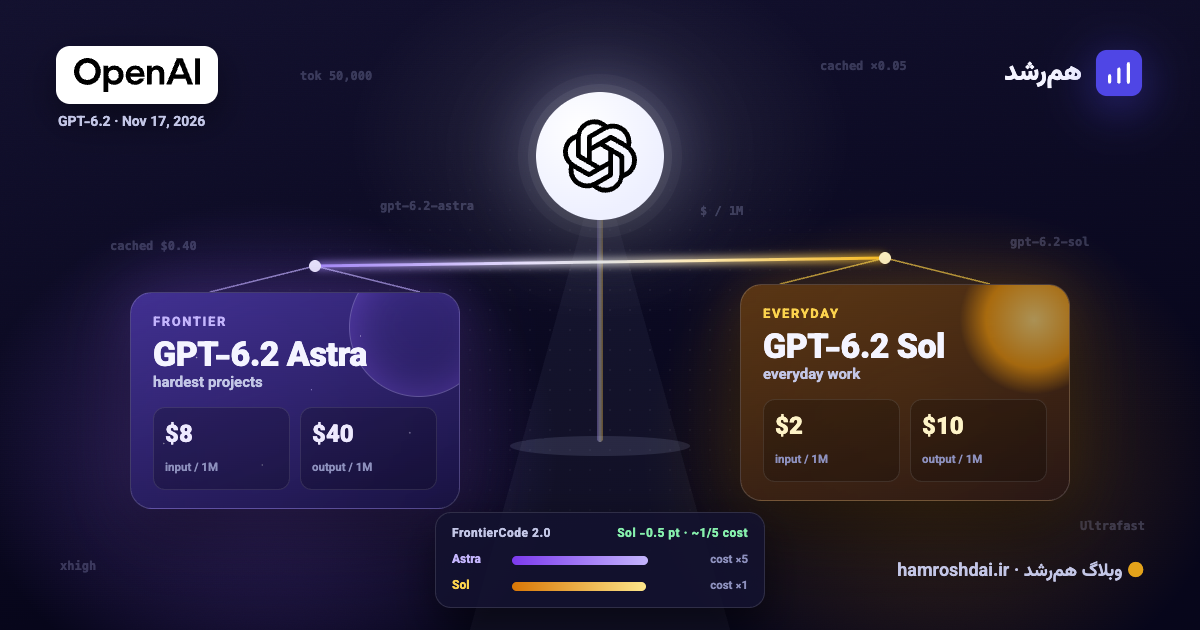
OpenAI روز ۱۷ نوامبر ۲۰۲۶ دو مدل تازه منتشر کرد: GPT-6.2 Astra و GPT-6.2 Sol. Astra مدل گران و پیشرو است و Sol مدل ارزان برای کارهای روزمره. نکتهٔ جالب خودِ عرضه نیست، فاصلهٔ این دو مدل است: در بعضی آزمونهای برنامهنویسیِ خود OpenAI، مدل Sol با حدود یکپنجمِ هزینه فقط نیم امتیاز از Astra عقبتر است. در همان حال، ارزیابهای مستقل دیدهاند که هیچکدام از دو مدل در برنامهنویسی پیشرفت چندانی نکردهاند.
پس سؤال مفید برای یک تیم این نیست که «GPT-6.2 خوب است یا نه؟»؛ سؤال این است که «کدام کارها ارزش Astra را دارند و کدام را باید به Sol سپرد؟» این راهنما واقعیتهای رسمی، نتایج مستقل و گلایههای اولیه را کنار هم میگذارد و از آنها یک نقشهٔ مسیریابی میسازد.
OpenAI دقیقاً چه چیزی منتشر کرد؟
طبق اطلاعیهٔ OpenAI در انجمن توسعهدهندگانش، نقش دو مدل روشن است:
GPT-6.2 Astra: «مدلی پیشرو برای سختترین پروژهها». به گفتهٔ OpenAI، این مدل در ارزیابیهای کار حرفهای و پژوهش علمی رکورد تازهای ثبت کرده و هزینهٔ هر کارش کمتر از یکسومِ GPT-6 Astra است.
GPT-6.2 Sol: «مدلی کارآمد و همهکاره برای کارهای روزمره».
هر دو مدل در ChatGPT Work و Codex برای کاربران Plus، Pro، Enterprise و Edu در دسترساند و در API با نامهای gpt-6.2-astra و gpt-6.2-sol عرضه شدهاند. یکی از کارکنان OpenAI در همان گفتوگو توضیح داده که این عرضه هیچکدام از دو مدل را به چتِ معمولی اضافه نمیکند و دسترسی به طرح اشتراک، مجوزهای فضای کار و پیشرفت عرضه بستگی دارد. سرویس سریعترِ «Ultrafast» در API و برای مشترکان Pro 500 روی هر دو مدل فعال است و مشترکان Pro 200 از Sol شروع میکنند.
قیمتها: فاصلهٔ ۴ برابری که روی هم انباشته میشود
قیمتهای رسمی برای هر یک میلیون توکن، به گزارش The Decoder و Tech Monitor:
ورودی | ورودیِ کششده | خروجی | |
|---|---|---|---|
GPT-6.2 Astra | ۸ دلار | ۰٫۴۰ دلار | ۴۰ دلار |
GPT-6.2 Sol | ۲ دلار | ۰٫۱۰ دلار | ۱۰ دلار |
Astra حدود ۲۰ درصد از GPT-6 Astra ارزانتر است و Sol همان قیمت GPT-6.1 Sol را نگه داشته. در هر ردیف فاصله ۴ برابر است و این فاصله در گردشکارهای عاملمحور خیلی زود بزرگ میشود.
یک مثال ساده: کاری مثل پاسخ به تیکت پشتیبانی یا بازبینی کد که ۵۰ هزار توکن ورودی میفرستد و ۵ هزار توکن جواب میگیرد، روی Astra حدود ۰٫۶۰ دلار (۰٫۴۰ + ۰٫۲۰) و روی Sol حدود ۰٫۱۵ دلار (۰٫۱۰ + ۰٫۰۵) هزینه دارد. اگر این کار ماهی ۲ هزار بار اجرا شود، اختلاف به حدود ۹۰۰ دلار میرسد.
دو جزئیات از عددهای اصلی مهمترند:
ورودیِ کششده ۹۵ درصد ارزانتر است. اگر پرامپتهایتان با دستورالعملهای طولانی، اسناد یا زمینهٔ کدِ ثابت شروع میشوند، این بخش آغازین را ثابت نگه دارید تا کش شود. این کار گاهی از انتخاب مدل هم مهمتر است.
کار واقعی توکن بیشتری از جدول قیمت مصرف میکند. ارزیاب Vals AI در آزمون با بیشترین سطح استدلال، میانگین هزینهٔ هر کار را برای Astra ۱۰٫۶۸ دلار و برای Sol ۳٫۱۸ دلار اندازه گرفت؛ یعنی Sol ارزانترین مدلِ ده مدل برترِ فهرستش است.
بنچمارکها: عددهای OpenAI و نگاه مستقل
ادعاهای اصلی OpenAI، به گزارش The Decoder و اطلاعیهٔ توسعهدهندگان:
Agents' Last Exam: Astra (در سطح تلاش «xhigh») ۵٫۲ امتیاز بالاتر از GPT-6 Astra است.
GDPval-v2 (کارهای حرفهای): Astra نسبت به نسخهٔ قبل ۶٫۲ واحد درصد بهتر شده و ۲۲ درصد توکن خروجی کمتری مصرف میکند.
FrontierCode 2.0 (تغییرات آمادهٔ ادغام در کدهای واقعی، ساختهٔ Cognition): Sol با حدود یکپنجمِ هزینه فقط ۰٫۵ امتیاز از Astra عقب است.
نتایج ارزیابهای مستقل یکدست نبود:
Artificial Analysis به Astra در شاخص هوشش امتیاز ۶۲ داده؛ پس از Claude Fable 5.2 با ۶۵، در جای دوم. Sol امتیاز ۵۷ گرفته است. در شاخص عامل برنامهنویسیِ همین مؤسسه، Astra نسبت به GPT-6 Astra تغییری نکرده و Sol نسبت به GPT-6.1 Sol سه امتیاز افت کرده که بیشترش به افت ۱۴ امتیازی در یک آزمون پرسشوپاسخ دربارهٔ مخزن کد برمیگردد.
نرخ توهم در آزمون AA-Omniscience همین مؤسسه، با بیشترین سطح تلاش، برای Astra ۵۹ درصد و برای Sol ۵۵ درصد بود.
Epoch AI به Astra در شاخص تواناییهایش امتیاز ۱۷۴ داد، همتراز با Claude Fable 5.2، اما نوشت که Astra در کارهای دنیای واقعی تقریباً از GPT-6 Astra جلوتر نرفته است.
Vals AI در فهرست کلیاش Astra را هفتم و Sol را نهم گذاشته و نقطهضعف آشکار هر دو را پژوهش حقوقی دانسته است.
گزارشهای اولیه و نکتههای ایمنی
Android Authority گلایههای آزمایشکنندگان اولیه را جمع کرده است: چرخههای بیحاصل، اعلامِ تمامشدنِ کار پیش از موعد و پاسخهای گیجکننده، با وجود نتایج خوب در بنچمارکها. تیبو سوتیو از OpenAI در پاسخ گفت شرکت در سه تا چهار روز آخرِ پیش از عرضه تغییرات مهمی داده که برخی ارزیابها آن را ندیدهاند و بهتر کردنِ ذوق خلاقانه و سهولت استفاده هنوز در برنامه است. در گفتوگوی انجمن توسعهدهندگان هم چند کاربر از کیفیت نثر این مدلها انتقاد کردهاند.
در بخش ایمنی، OpenAI میگوید هر دو مدل با محافظتهای سختگیرانهتری برای کمکهای پرخطر در امنیت سایبری عرضه شدهاند. به نوشتهٔ GCN به نقل از کارت سیستم، هر دو مدل در چارچوب آمادگی OpenAI به آستانهٔ «Critical» در امنیت سایبری رسیدهاند و Astra نخستین مدلی است که OpenAI بیرون از شرکت عرضه میکند و به آستانهٔ «High» در خودبهبودیِ هوش مصنوعی رسیده است. The Decoder جزئیاتی از آزمونهای همراستاییِ خود OpenAI هم آورده که برای عاملها مهم است: این مدلها بیشتر از قبل، مانعهایی را که جلوی کارشان را گرفته بود گزارش نکردهاند.
اگر این را کنار «اعلامِ زودهنگامِ پایان کار» بگذارید، پیام روشن است: اگر به هر کدام از این مدلها ابزار و اختیار میدهید، برای کارهای مهم نقطهٔ تأیید انسانی بگذارید. راهنمای ما دربارهٔ اینکه عامل هوش مصنوعی کی باید اجازه بگیرد نحوهٔ چیدن این نقطهها را توضیح میدهد.
Astra یا Sol: نقشهٔ مسیریابی برای تیمها
یک پیشفرض عملی: هر کاری را با Sol شروع کنید و فقط وقتی به Astra ببرید که نشان دهید Sol در آن شکست میخورد.
نوع کار | شروع با | کی به Astra ببرید |
|---|---|---|
پیشنویس، خلاصه، ترجمه، دستهبندی | Sol | بهندرت؛ اول کیفیت نوشتن را روی نمونههای خودتان بسنجید |
برنامهنویسی روزمره، بازآرایی و بازبینی کد | Sol | Sol بارها در آزمونهایتان رد شود یا مخزن را اشتباه بفهمد |
کارهای طولانی و چندمرحلهای عاملها (پژوهش، تحلیل) | Sol برای آزمایش | کار مرحلههای وابستهٔ زیادی دارد و خطا گران تمام میشود |
تحلیل علمی، مالی یا مهندسی | Astra | — |
پژوهش حقوقی | هیچکدام بهطور پیشفرض | فقط با بازبینی متخصص؛ هر دو در آزمونهای حقوقی Vals رتبهٔ پایینی دارند |
برای اینکه این تصمیم را با داده بگیرید، نه با حس:
یک مجموعهٔ ارزیابی کوچک بسازید. ۲۰ تا ۳۰ کار واقعی از کار خودتان جمع کنید و تعریف روشنی از «نتیجهٔ قابلقبول» بنویسید.
هزینهٔ هر نتیجهٔ قابلقبول را بسنجید، نه هزینهٔ هر توکن. مدل ارزانتری که دو بار تلاش دوباره لازم دارد، ممکن است از Astra که یک بار درست انجامش میدهد گرانتر شود.
حالتهای شکستِ شناختهشده را زیر نظر بگیرید. کارهایی را که «تمامشده» اعلام شدهاند ولی تمام نیستند و عاملهایی را که بیپیشرفت دور خودشان میچرخند بررسی کنید.
از کش استفاده کنید. بخش طولانی و ثابتِ هر پرامپت را در ابتدا و در همهٔ فراخوانیها یکسان نگه دارید.
چند هفتهٔ دیگر دوباره بسنجید. OpenAI خودش گفته مدلها درست پیش از عرضه تغییر کردهاند؛ رفتارشان ممکن است باز هم عوض شود.
در همرشد، اینکه فضای کار از کدام مدلهای هوش مصنوعی استفاده کند با مدیرهاست و مصرف هوش مصنوعی با اعتبار حساب میشود؛ بنابراین همین مسیریابیِ کار به کار، مستقیماً به نحوهٔ تنظیم کارمندهای هوش مصنوعی و دستیارِ تیم ترجمه میشود.
جمعبندی
GPT-6.2 Astra برای کارهای سخت حرفهای و علمی گامی واقعی است، آن هم با قیمتی کمتر از نسخهٔ قبل. اما برای بیشتر کارهای روزمرهٔ تیمها، خبر مهمتر Sol است: در چند آزمون برنامهنویسی نزدیک به Astra، با یکچهارمِ قیمت رسمی. آزمونهای مستقل نشان میدهند پیشرفت برنامهنویسی در این نسخه متوقف شده و نرخ توهم همچنان بالاست؛ پس کار عاقلانه این است که Sol را پیشفرض بگذارید، ثابت کنید Astra کجا ارزش قیمتش را دارد و برای کارهای پیامددار، انسان را در حلقه نگه دارید.
تحلیلهای بیشتر دربارهٔ مدلهای هوش مصنوعی و ابزارهای توسعه را در وبلاگ همرشد بخوانید.
منابع
GPT-6.2 Astra and Sol are now available (انجمن توسعهدهندگان OpenAI، ۱۷ نوامبر ۲۰۲۶)
OpenAI launches GPT-6.2 Astra and Sol with lower API prices and some benchmark gains (The Decoder، ۱۷ نوامبر ۲۰۲۶)
OpenAI rolls out GPT-6.2 Astra and Sol models (Tech Monitor، ۱۸ نوامبر ۲۰۲۶)
OpenAI launches GPT-6.2 Astra and Sol, but not everyone is sold on the cheaper upgrade (Android Authority، ۱۸ نوامبر ۲۰۲۶)
OpenAI launches GPT-6.2 Astra and Sol AI models (GCN، ۱۹ نوامبر ۲۰۲۶)
تصویر: نماد OpenAI.svg) و نوشتار لوگوی OpenAI.svg) از Wikimedia Commons (مالکیت عمومی)؛ نشانهای تجاری متعلق به OpenAI است.
مقالههای مرتبط
Siri AI برای همهٔ توسعهدهندگان باز شد؛ اپلیکیشن شما برای دستیارها آماده است؟
اپل در ۳ نوامبر Siri AI را به روی همهٔ اپلیکیشنها باز کرد، اما انتشار در App Store تا بهار صبر میخواهد. این سازوکار چطور کار میکند و تیمهای محصول از همین حالا چه کنند؟
Gemini 4 Carbon و امنیت سایبری با هوش مصنوعی: چه چیزی تغییر کرد؟
گوگل مدل Gemini 4 Carbon را اول فقط به مدافعان سایبری داد و حالا برای همه باز کرده است. عددهایش چه میگویند و یک تیم کوچک چطور میتواند امن از آن استفاده کند؟
عامل هوش مصنوعی کی باید اجازه بگیرد؟ راهنمای عملی دروازههای تأیید
عاملی که میتواند ایمیل بفرستد یا پول برگرداند، کلید ساختمان را در دست دارد. با دو سؤال ساده تصمیم بگیرید کدام کار را خودش انجام دهد و کجا پیش از اجرا از یک انسان اجازه بگیرد.