عامل هوش مصنوعی کی باید اجازه بگیرد؟ راهنمای عملی دروازههای تأیید
عاملی که میتواند ایمیل بفرستد یا پول برگرداند، کلید ساختمان را در دست دارد. با دو سؤال ساده تصمیم بگیرید کدام کار را خودش انجام دهد و کجا پیش از اجرا از یک انسان اجازه بگیرد.
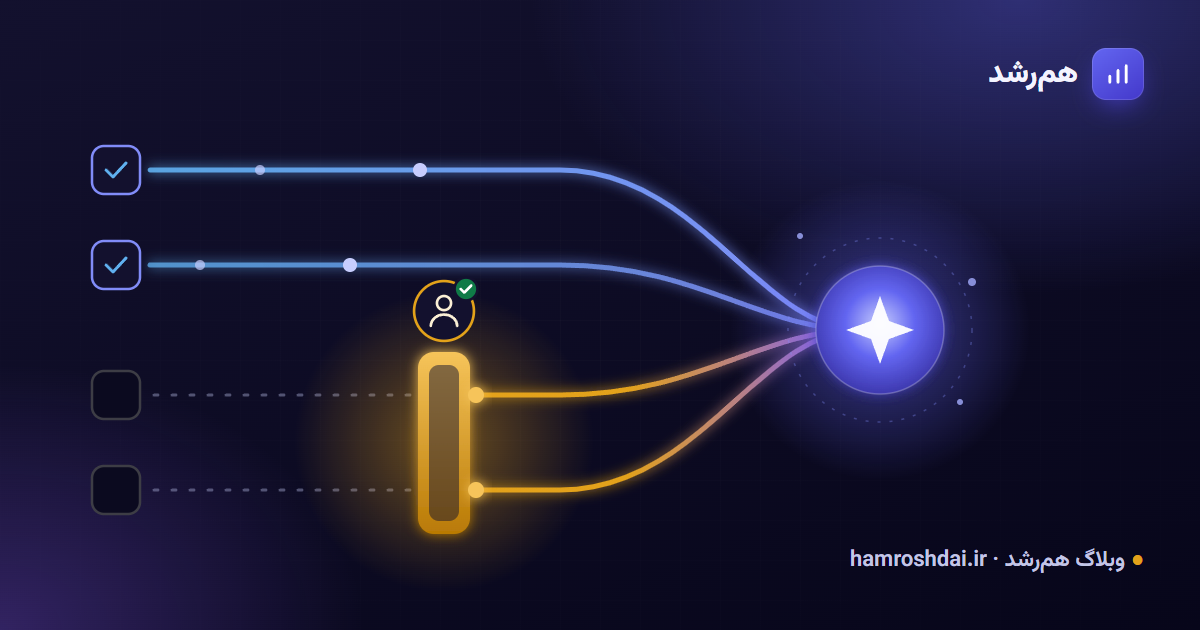
عامل هوش مصنوعیای که فقط به سؤالها جواب میدهد، در عمل یک جعبهٔ جستوجوی مؤدب است. اما از لحظهای که بتواند برای مشتری ایمیل بفرستد، معاملهای را «بستهشده» علامت بزند، پولی را برگرداند یا دسترسی کسی را به یک پوشه عوض کند، تبدیل میشود به همکاری که کلید ساختمان را در دست دارد. تیمها دقیقاً برای همین سراغ عاملها میروند، و بسیاری از پروژههای عاملمحور هم دقیقاً به همین دلیل زمینگیر میشوند: کسی تصمیم نگرفته که عامل کدام کلیدها را حق دارد خودش بچرخاند.
این راهنما دربارهٔ همین تصمیم است. سؤال این نیست که «از عاملها استفاده کنیم یا نه»؛ سؤال دقیقتر و کاربردیتری است: برای هر نوع کار، عامل باید خودش انجام دهد، انجام دهد و خبر بدهد، یا بایستد و اجازه بگیرد؟
خودمختاری کامل هدف درستی نیست
در بسیاری از تبلیغات، موفقیت یک عامل را با این میسنجند که انسان چقدر کمتر در کار دخالت دارد. این نگاه دردسر میسازد. خبرگزاری رویترز در ژوئن ۲۰۲۵ پیشبینی گارتنر را منتشر کرد که میگوید بیش از ۴۰ درصد پروژههای هوش مصنوعی عاملمحور تا پایان ۲۰۲۷ لغو میشوند؛ به دلیل هزینههای روبهافزایش و ارزش تجاری نامشخص. همان گزارش از پدیدهای به اسم «عاملشویی» (agent washing) میگوید، یعنی برچسب «عامل» زدن به چتباتها و دستیارهای معمولی، و تخمین میزند که از میان هزاران فروشندهٔ این حوزه فقط حدود ۱۳۰ مورد واقعاً عامل میسازند.
همین پیشبینی انتظار دارد تا سال ۲۰۲۸ دستکم ۱۵ درصد تصمیمهای روزمرهٔ کاری بهطور خودکار و با هوش مصنوعی عاملمحور گرفته شود؛ رقمی که در ۲۰۲۴ صفر بود. این دو عدد با هم تناقضی ندارند. عاملها سهم بزرگتری از تصمیمهای تکراری را به دست میگیرند، و پروژههایی که میخواهند همهچیز را یکجا خودکار کنند، بدون اینکه بدانند کجا قضاوت انسانی لازم است، گران و غیرقابلاعتماد از آب درمیآیند.
پس هدف عملی «بیشترین خودمختاری» نیست. هدف میزان درست خودمختاری برای هر کار است، همراه با فرایندی که در آن مرحلههای انسانی آنقدر سریع باشند که آدمها از آنها خسته نشوند.
خطر واقعی اسم دارد: اختیار بیش از حد
متخصصان امنیت برای این مشکل اصطلاح دقیقی دارند. فهرست ده خطر اصلی OWASP برای برنامههای مبتنی بر مدلهای زبانی آن را اختیار بیش از حد (Excessive Agency) مینامد: آسیبپذیریای که باعث میشود در پاسخ به خروجی غیرمنتظره، مبهم یا دستکاریشدهٔ مدل، کاری زیانبار انجام شود؛ فارغ از اینکه چرا مدل خطا کرده است.
OWASP سه ریشه برای آن برمیشمارد:
قابلیت بیش از حد: عامل ابزارهایی دارد که لازمشان ندارد؛ مثلاً ابزار «ارسال ایمیل» برای عاملی که فقط باید صندوق پیام را خلاصه کند.
مجوز بیش از حد: دامنهٔ ابزارها بیش از نیاز است؛ مثلاً اتصال به پایگاه دادهای که اجازهٔ حذف دارد، در حالی که فقط خواندن لازم است.
خودمختاری بیش از حد: کارهای پراثر بدون اینکه کسی پیش از اجرا بررسیشان کند انجام میشوند.
نکتهٔ مهم این است که لازم نیست مدل «بدخواه» باشد یا حتی زیاد اشتباه کند. یک شناسهٔ مشتری اشتباه، یک دستور مبهم، یا جملهای که در متن یک ایمیل ورودی پنهان شده (تزریق پرامپت) کافی است. اگر کلیدها دست عامل باشد، یک خطای کوچک به یک اقدام واقعی تبدیل میشود.
راهی ساده برای تصمیم: برگشتپذیری و دامنهٔ اثر
برای شروع، به چارچوب پیچیدهٔ مدیریت ریسک نیازی نیست. دو سؤال بیشتر کارها را دستهبندی میکند:
آیا میشود این کار را سریع و کامل برگرداند؟
چه کسی بیرون از خود کاربر آن را میبیند یا اثرش را حس میکند؟
نوع کار | نمونهها | پیشفرض منطقی |
|---|---|---|
فقط خواندن | جستوجو در اسناد، خلاصهٔ یک گفتوگو، پیشنویس جواب برای خود کاربر | انجام بده و منابعی را که استفاده کردی نشان بده |
تغییر داخلی و برگشتپذیر | برچسب زدن به سرنخ، بهروزرسانی یک فیلد وظیفه، ثبت یادداشت | انجام بده یا برای یک دسته یکبار اجازه بگیر؛ سابقه نگه دار و امکان برگرداندن آسان بده |
دیدهشده توسط دیگران یا سختبرگشت | ایمیل به مشتری، تغییر مرحلهٔ معامله، انتشار یک صفحه | پیش از هر کار اجازه بگیر و دقیقاً نشان بده چه اتفاقی میافتد |
پول، قرارداد، افراد، دسترسی | بازپرداخت، تخفیف، تغییر حقوق، تغییر مجوزها | از مسیر عادی تأیید سازمان بگذران؛ گاهی با تأیید دو نفر |
دو نکته مهم است. اول اینکه جدول پیشفرضها را نشان میدهد، نه قانونی ثابت را؛ تیمی که ماهها با یک عامل کار کرده ممکن است بعضی کارها را یک ردیف بالاتر ببرد. دوم اینکه ردیف آخر «قانون مخصوص هوش مصنوعی» نیست. یک کارمند تازهکار هم نمیتواند تخفیف خودش را خودش تأیید کند. عامل هم باید همان مسیر تأییدی را برود که یک انسان میرود.
درخواست تأیید خوب چه شکلی دارد؟
نقطهٔ کنترل انسانی فقط وقتی محافظت میکند که آدم واقعاً آن را بخواند. پیامهایی مثل «عامل میخواهد ۴ کار انجام دهد. اجازه میدهید؟» به آدمها یاد میدهند بیفکر روی «بله» بزنند. قانون هوش مصنوعی اتحادیهٔ اروپا در مادهٔ ۱۴ دربارهٔ نظارت انسانی دقیقاً به همین مشکل اشاره میکند: کسانی که بر یک سامانه نظارت میکنند باید مراقب سوگیری خودکارسازی باشند؛ یعنی تمایل به اعتماد بیش از حد به خروجی سامانه.
درخواستی که ارزش تأیید دارد اینها را نشان میدهد:
چه چیزی تغییر میکند، به شکل مشخصِ «قبل و بعد»، نه توصیفی از نیت عامل.
چرا، با پیوند به پیام، رکورد یا دستوری که باعث این کار شده است.
چه کسی تحت تأثیر قرار میگیرد، بهخصوص اگر کسی بیرون از تیم باشد.
چطور میشود آن را برگرداند، یا هشداری روشن که برگشتپذیر نیست.
درخواستهای کمخطر را دستهای کنید و درخواستهای پرخطر را جدا نگه دارید. اگر تأییدکننده روزی چهل درخواست ببیند، درخواست مهم هم همراه سیونه تای دیگر تأیید میشود.
محافظهایی که به رفتار درست مدل وابسته نیستند
تأیید فقط یک لایه است. لایههای دیگر باید حتی وقتی مدل گیج شده یا فریب خورده هم سر جایشان بمانند:
حداقل دسترسی. به هر عامل فقط ابزارها و مجوزهایی را بدهید که کارش لازم دارد. OWASP کم کردن افزونهها، قابلیتها و مجوزهای آنها را نخستین خط دفاع میداند.
کار در چارچوب دسترسی کاربر. عاملی که برای یک نفر کار میکند باید فقط چیزهایی را ببیند و تغییر دهد که همان آدم اجازه دارد؛ نه اینکه با یک حساب سرویس همهکاره بیسروصدا از مجوزها عبور کند.
اعمال قواعد بیرون از مدل. OWASP به این «میانجیگری کامل» میگوید: سامانهای که دستور را دریافت میکند خودش بررسی کند که کار مجاز است یا نه، بهجای اینکه به قضاوت مدل تکیه کند.
ثبت همهچیز و محدود کردن سرعت. سابقه و محدودیت تعداد درخواست جلوی اشتباه را نمیگیرند، اما دامنهٔ آسیب را محدود میکنند و فهمیدن ماجرا را ممکن میسازند.
یک دکمهٔ توقف واقعی. مادهٔ ۱۴ میخواهد که بشود سامانهٔ پرخطر را «با دکمهٔ توقف یا روشی مشابه» در وضعیتی امن متوقف کرد.
ساده شروع کنید. راهنمای مهندسی آنتروپیک با عنوان ساختن عاملهای کارآمد توصیه میکند سادهترین راهحلی را که جواب میدهد انتخاب کنید، شرط توقف بگذارید (مثل سقف تعداد مراحل)، نقطههایی برای مکث و گرفتن نظر انسان در نظر بگیرید و عامل را پیش از استفادهٔ واقعی در محیطی ایزوله حسابی آزمایش کنید.
قانونگذاری به کدام سمت میرود؟
بیشتر عاملهای کسبوکار از نظر حقوقی «سامانهٔ پرخطر» به معنای قانون هوش مصنوعی اروپا نیستند؛ این عنوان حوزههایی مثل تصمیمهای استخدامی، اعتبارسنجی و آموزش را در بر میگیرد. با این حال، مادهٔ نظارت انسانی این قانون برای همه چکلیست خوبی است، چون تواناییهایی را که یک ناظر باید داشته باشد توصیف میکند: محدودیتهای سامانه را بفهمد، خروجیاش را درست تفسیر کند، تصمیم بگیرد از آن استفاده نکند، نتیجهاش را نادیده بگیرد یا برگرداند، و آن را متوقف کند.
زمانبندی هم تغییر کرده است. بستهٔ «Digital Omnibus» برای هوش مصنوعی، یعنی مقررات ۲۰۲۶/۱۷۴۴ اتحادیهٔ اروپا، از ۲۷ ژوئیهٔ ۲۰۲۶ لازمالاجرا شده و تاریخ اجرای الزامات سامانههای پرخطرِ پیوست سوم را از ۲ اوت ۲۰۲۶ به ۲ دسامبر ۲۰۲۷، و برای سامانههای مشمول پیوست اول به ۲ اوت ۲۰۲۸ منتقل کرده است. تیمهایی که عاملهایشان با استخدام، وامدهی یا تصمیمهای مشابه سروکار دارد حالا زمان بیشتری دارند، اما جهت حرکت روشن است: نظارت انسانی واقعی دارد به یک الزام طراحی تبدیل میشود، نه یک امکان اضافه.
همرشد چطور با این موضوع کنار میآید؟
همرشد آگاهانه محتاطترین سر این طیف را انتخاب کرده است. عاملهای همرشد فضای کار را جستوجو میکنند، میخوانند و تغییر میدهند، ولی پیش از هر تغییر اجازه میگیرند. دستیار فقط چیزهایی را میبیند که کاربرش اجازهٔ دیدنشان را دارد و در جوابهایش صفحههایی را که از آنها استفاده کرده نشان میدهد. درخواستهایی مثل تخفیف یا قرارداد هم از طریق بخش «تأییدها» به تأییدکنندهٔ درست میرسند؛ همان مسیری که درخواست یک همکار انسانی طی میکند.
این انتخاب چند کلیک هزینه دارد. در عوض، تیم میتواند بگذارد دستیار در فروش، پشتیبانی و عملیات کار واقعی انجام دهد، بدون اینکه نگران باشد شب گذشته چه چیزی را عوض کرده است. با هر ابزاری که کار میکنید، سؤالهای این مقاله نقطهٔ شروع خوبیاند: این عامل به چه چیزهایی دسترسی دارد، چه کارهایی برگشتپذیرند، و چه کسی پیش از اجرا درخواست را میبیند؟
راهنماهای کاربردی دیگر را در وبلاگ همرشد بخوانید.
منابع
رویترز به نقل از The Star، ۲۵ ژوئن ۲۰۲۵: Over 40% of agentic AI projects will be scrapped by 2027, Gartner says
پروژهٔ امنیت هوش مصنوعی مولد OWASP: LLM06:2025 Excessive Agency
قانون هوش مصنوعی اتحادیهٔ اروپا: مادهٔ ۱۴، نظارت انسانی
قانون هوش مصنوعی اتحادیهٔ اروپا: Digital Omnibus on AI، مقررات ۲۰۲۶/۱۷۴۴
آنتروپیک، ۱۹ دسامبر ۲۰۲۴: Building effective agents
مقالههای مرتبط
Gemini 4 Carbon و امنیت سایبری با هوش مصنوعی: چه چیزی تغییر کرد؟
گوگل مدل Gemini 4 Carbon را اول فقط به مدافعان سایبری داد و حالا برای همه باز کرده است. عددهایش چه میگویند و یک تیم کوچک چطور میتواند امن از آن استفاده کند؟
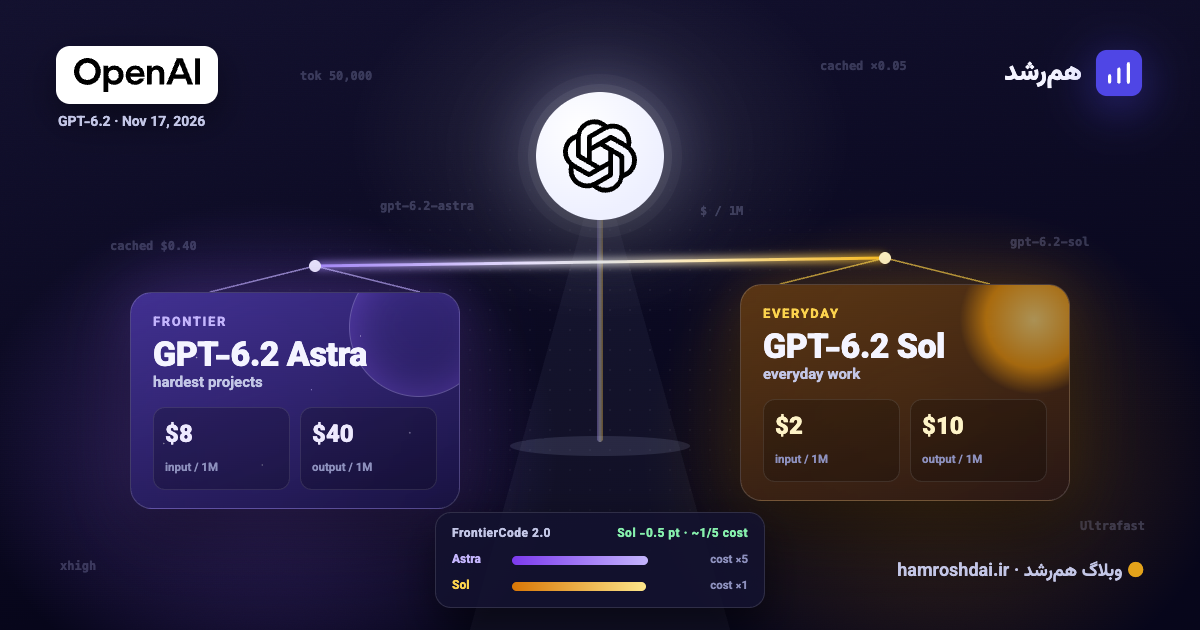
GPT-6.2 Astra یا Sol؛ کدام کار تیم را به کدام مدل تازهٔ OpenAI بسپاریم؟
OpenAI دو مدل GPT-6.2 Astra و Sol را با فاصلهٔ قیمت ۴ برابری عرضه کرد. قیمتها، بنچمارکهای رسمی و مستقل، گلایههای اولیه و یک نقشهٔ عملی برای انتخاب مدل.
Siri AI برای همهٔ توسعهدهندگان باز شد؛ اپلیکیشن شما برای دستیارها آماده است؟
اپل در ۳ نوامبر Siri AI را به روی همهٔ اپلیکیشنها باز کرد، اما انتشار در App Store تا بهار صبر میخواهد. این سازوکار چطور کار میکند و تیمهای محصول از همین حالا چه کنند؟