Gemini 4 Carbon و امنیت سایبری با هوش مصنوعی: چه چیزی تغییر کرد؟
گوگل مدل Gemini 4 Carbon را اول فقط به مدافعان سایبری داد و حالا برای همه باز کرده است. عددهایش چه میگویند و یک تیم کوچک چطور میتواند امن از آن استفاده کند؟
گوگل روز ۱۹ آبان ۱۴۰۵ (۱۰ نوامبر ۲۰۲۶) مدل Gemini 4 Carbon را برای همهٔ توسعهدهندگان و سازمانهایی که از API پولی آن استفاده میکنند در دسترس گذاشت. فقط دو هفته پیشتر، همین مدل تنها در اختیار گروه برگزیدهای از متخصصان دفاع سایبری بود. این ترتیب انتشار نکتهٔ مهمی دربارهٔ آیندهٔ امنیت سایبری با هوش مصنوعی میگوید: قویترین مدلها دیگر فقط با کیفیت کدنویسی سنجیده نمیشوند، بلکه با تواناییشان در پیدا کردن، بهرهبرداری و رفع حفرههای امنیتی همان کد هم سنجیده میشوند.
در این مقاله میبینیم گوگل دقیقاً چه چیزی منتشر کرده، عددهایش چه چیزی را نشان میدهند و چه چیزی را نه، و یک تیم کوچک یا متوسط با چنین مدلی چه باید بکند.
گوگل چه چیزی را و به چه ترتیبی منتشر کرد
گوگل روز ۶ آبان (۲۸ اکتبر) مدل Carbon را «مدل پیشرو بعدی» خود معرفی کرد، اما آن را برای همه باز نکرد. دسترسی از «بخشی از مدافعان سایبری» شروع شد و قرار بود بهتدریج به شریکان مورد اعتماد در برنامهٔ Fairwind برسد.
خود برنامهٔ Fairwind قدیمیتر است. گوگل آن را روز ۱۱ شهریور (۲ سپتامبر) بهعنوان برنامهای با دسترسی محدود برای دولتها و شریکان مورد اعتماد راه انداخت؛ نخست با یک مدل قبلی که برای امنیت تنظیم شده بود و ابزار CodeMender. به گفتهٔ گوگل بیش از ۶۵۰ شریک در آن حضور دارند و باید دسترسی را به تیمهای داخلی امنیت، پاسخ به رخداد یا تست نفوذ محدود کنند و احراز هویت چندمرحلهای به کار ببرند.
سپس در ۱۹ آبان (۱۰ نوامبر) گوگل Carbon را از طریق Google AI Studio و Gemini for business برای همهٔ توسعهدهندگان و سازمانهای پرداختکننده باز کرد و عرضهٔ آن را برای مشترکان Google AI Ultra در اپلیکیشنهای عمومیاش آغاز کرد. یادداشتهای انتشار Gemini API هم همین تاریخ را برای عرضهٔ عمومی gemini-4-carbon ثبت کردهاند.
تاریخ | رویداد |
|---|---|
۱۱ شهریور ۱۴۰۵ (۲ سپتامبر ۲۰۲۶) | آغاز برنامهٔ Fairwind برای دولتها و شریکان مورد اعتماد |
۶ آبان ۱۴۰۵ (۲۸ اکتبر ۲۰۲۶) | معرفی Carbon و دسترسی بخشی از مدافعان سایبری |
۱۹ آبان ۱۴۰۵ (۱۰ نوامبر ۲۰۲۶) | عرضهٔ عمومی برای توسعهدهندگان و سازمانهای پرداختکننده |
۹ آذر ۱۴۰۵ (۳۰ نوامبر ۲۰۲۶) | پایان قیمت معرفی |
چرا مدلِ «سایبری» جور دیگری منتشر میشود
بیشتر مدلها در یک روز عرضه میشوند: اعلام، API و قیمت. Carbon مرحلهبهمرحله منتشر شد، چون مهارتهایی که گوگل برجسته میکند دوکاربردیاند. مدلی که در پیدا کردن حفرهٔ امنیتی کد شما خوب است، طبیعتاً در پیدا کردن حفرهٔ کد دیگران هم خوب است.
دادن فرصت زودتر به مدافعان یک شرطبندی آگاهانه است. اگر تیمهای امنیتی بتوانند پیش از رواج گستردهٔ این توانایی، سامانههایشان را بررسی و وصله کنند، کفهٔ ترازو کمی به سمت دفاع سنگین میشود. گوگل همچنین میگوید پیش از عرضه در «فرایند داوطلبانهٔ دولت آمریکا برای آزمایش مدل پیش از انتشار» شرکت کرده است.
همین کشمکش در کل صنعت دیده میشود. Help Net Security در مرداد گزارش داد که در یک رخداد، به تعبیر خودش، «مجموعهای از عاملهای هوش مصنوعی» بهطور خودکار و با زنجیره کردن حفرههای ناشناخته و اطلاعات ورودی لورفته در اینترنت، به زیرساخت پژوهشی OpenAI نفوذ کردهاند. طبق همین گزارش، پاسخ OpenAI هم بر هوش مصنوعی تکیه دارد: ابزارهایی که تغییرات کد را اعتبارسنجی میکنند، بررسی اولیهٔ تقریباً همهٔ هشدارهای امنیتی با هوش مصنوعی، و مدلهایی که مسیرهای حمله مانند خطاهای پیکربندی و دسترسیهای بیش از حد را جستوجو میکنند.
الگو روشن است: مهاجم و مدافع به یک دسته ابزار دسترسی پیدا میکنند و تفاوت در این است که چه کسی زودتر و با دقت بیشتری از آنها استفاده کند.
عددها چه میگویند و چه نمیگویند
گوگل چند نتیجهٔ بنچمارک برای مهارتهای امنیتی Carbon منتشر کرده است. در پست معرفی، این نتایج سه مرحلهٔ کار را پوشش میدهند:
کار | بنچمارک | امتیاز Carbon (طبق اعلام گوگل) |
|---|---|---|
پیدا کردن حفره | SEC-bench Pro | ۸۸٫۲٪ |
بهرهبرداری از حفره | ExploitGym | ۵۴٫۸٪ |
وصله کردن حفره | CWE-bench | ۷۱٫۰٪ |
سه نکتهٔ احتیاطی را باید در نظر داشت:
اینها عددهای خود سازندهاند. گوگل آنها را اجرا یا گزارش کرده و یادآوری میکند که «بدون محافظها» ارزیابی شدهاند. نتایج مستقل زمان میبرد.
بنچمارک، کد شما نیست. امتیاز روی مجموعهای گزیده از باگهای شناختهشده دربارهٔ یک سامانهٔ داخلی دهساله بدون تست و با وابستگیهای عجیب چیز زیادی نمیگوید.
امتیاز بهرهبرداری دو لبه دارد. مدلی که در بیش از نیمی از کارهای بهرهبرداری موفق است، برای اثبات واقعی بودن یک باگ مفید است و همین هم دلیل عرضهٔ مرحلهای بوده است.
گوگل برای عرضهٔ عمومی عددهای ایمنی هم گزارش کرده است. به گفتهٔ گوگل، Carbon در آزمونهای حملهٔ شبیهسازیشده «۹۹٪ از مسیرهای حمله را مسدود کرد» و نرخ نفوذ در هر تلاش ۰٫۸٪ بود، در مقایسه با ۳٫۱٪ برای Gemini 4 Argon. گوگل همچنین به آزمون بیرونی Trajectory Labs اشاره میکند که در ۱۳۲ ساعت و بیش از ۱۳ هزار درخواست، هیچ روش دور زدن فراگیر تازهای پیدا نکرد. این عددها مهماند، اما لایههای ایمنی اطراف مدل را توصیف میکنند، نه تضمینی که سوءاستفاده ناممکن باشد.
کجا به یک تیم کوچکتر کمک میکند
بیشتر شرکتها تیم قرمز ندارند. یک یا دو مهندس دارند که امنیت را هم کنار کار اصلیشان انجام میدهند، فهرستی بلند از هشدارهای وابستگیها و حسی مبهم که چیزی بهروز نیست. اینجا یک مدل قوی و آشنا با امنیت میتواند واقعاً کمک کند:
بازبینی کد پیش از انتشار. از مدل بخواهید یک تغییر را از نظر تزریق، احراز هویت و خطاهای دسترسی بررسی کند و هر یافته را با خطوط دقیق کد توضیح دهد.
تبدیل گزارش شلوغ اسکنرها به فهرستی کوتاه. اسکنرهای خودکار گزارشهای طولانی میسازند. مدل میتواند موارد تکراری را یکی کند، بگوید کدامها از بیرون قابل دسترسیاند و ترتیبی برای رفعشان پیشنهاد دهد.
نوشتن پیشنویس وصله و تست. برای باگی که تأیید شده، میتواند هم اصلاح و هم تستی را که باید آن را میگرفت پیشنویس کند. ادغام همچنان با یک توسعهدهنده است.
توضیح رخدادها. با لاگهای سامانههای خودتان میتواند کمک کند بفهمید چه اتفاقی و به چه ترتیبی افتاده؛ کاری که اغلب کندترین بخش پاسخ به رخداد است.
نقطهٔ مشترک همهٔ اینها این است که مدل روی کد و سامانههای خود شما کار میکند و تصمیم دربارهٔ نتیجه با یک انسان است.
چطور از آن استفاده کنیم بیآنکه خطر تازه بسازیم
مدلی امنیتی که کد شما را میخواند و ابزار اجرا میکند، خودش یک عامل قدرتمند است. قواعد همیشگی عاملها اینجا هم برقرارند و چند قاعدهٔ دیگر هم اضافه میشود:
فقط سراغ سامانههایی بروید که مال شماست یا مجوز آزمودنشان را دارید. اسکن زیرساخت دیگران، با هر ابزاری، منطقهٔ خاکستری نیست.
آن را در محیط ایزوله اجرا کنید. یک نسخه از مخزن کد و یک محیط آزمایشی به آن بدهید، نه اطلاعات ورود به محیط اصلی.
دسترسیها را محدود نگه دارید. برای بازبینی فقط خواندن؛ نوشتن فقط روی یک شاخهٔ جدا، هرگز مستقیم روی شاخهٔ اصلی.
پیش از هر تغییر، تأیید انسانی بگیرید. وصلهها، تغییرات پیکربندی و افشای حفرهها باید منتظر تأیید بمانند. طراحی این نقطههای تأیید را در مقالهٔ عامل هوش مصنوعی کی باید اجازه بگیرد؟ شرح دادهایم.
بدانید چه چیزی میفرستید. کد منبع، لاگها و دادههای مشتری که به یک API بیرونی فرستاده میشوند از شبکهٔ شما خارج میشوند. پیش از شروع، شرایط دادهٔ ارائهدهنده را بخوانید و رمزها و کلیدها را حذف کنید.
یافتهها را راستیآزمایی کنید. هر حفرهٔ گزارششده را تا وقتی کسی آن را بازتولید نکرده، یک فرضیه بدانید.
در ادامه به چه چیزی باید توجه کرد
قیمت معرفی ۲ دلار برای هر یک میلیون توکن ورودی و ۱۰ دلار برای هر یک میلیون توکن خروجی است. گوگل میگوید پس از ۹ آذر ۱۴۰۵ (۳۰ نوامبر ۲۰۲۶) قیمت برای دسترسی عمومی به ۴ و ۲۰ دلار میرسد؛ پس تیمهایی که اسکنهای بزرگ در نظر دارند باید بودجه را با نرخ بالاتر ببندند.
نشانهٔ مهمتر، ارزیابی مستقل خواهد بود. در ماههای آینده منتظر نتایج پژوهشگران امنیتیای باشید که در عرضه نقشی نداشتند، و گزارشهای شریکان Fairwind دربارهٔ آنچه مدل در سامانههای واقعی پیدا کرده است. اینها بیش از هر جدول معرفی حرف برای گفتن دارند.
برای تیمهای منطقهٔ ما، توصیهٔ عملی با هر مدلی یکی است: از کد خودتان شروع کنید، انسان را در حلقه نگه دارید و آنچه ابزار واقعاً پیدا میکند را اندازه بگیرید. راهنماهای بیشتر دربارهٔ کار امن با هوش مصنوعی در بلاگ همرشد منتظر شماست.
منابع
Google، ۶ آبان ۱۴۰۵ (۲۸ اکتبر ۲۰۲۶): Gemini 4 Carbon: our next frontier model
Google، ۱۹ آبان ۱۴۰۵ (۱۰ نوامبر ۲۰۲۶): Gemini 4 Carbon is now available
Google، ۱۱ شهریور ۱۴۰۵ (۲ سپتامبر ۲۰۲۶): Proactive cyber defense for governments and enterprises (Fairwind Program)
Google AI Studio: Gemini API release notes
Help Net Security، ۲۷ مرداد ۱۴۰۵ (۱۸ اوت ۲۰۲۶): OpenAI tightens defenses after AI agents breach research environment
مقالههای مرتبط
عامل هوش مصنوعی کی باید اجازه بگیرد؟ راهنمای عملی دروازههای تأیید
عاملی که میتواند ایمیل بفرستد یا پول برگرداند، کلید ساختمان را در دست دارد. با دو سؤال ساده تصمیم بگیرید کدام کار را خودش انجام دهد و کجا پیش از اجرا از یک انسان اجازه بگیرد.
GPT-6.2 Astra یا Sol؛ کدام کار تیم را به کدام مدل تازهٔ OpenAI بسپاریم؟
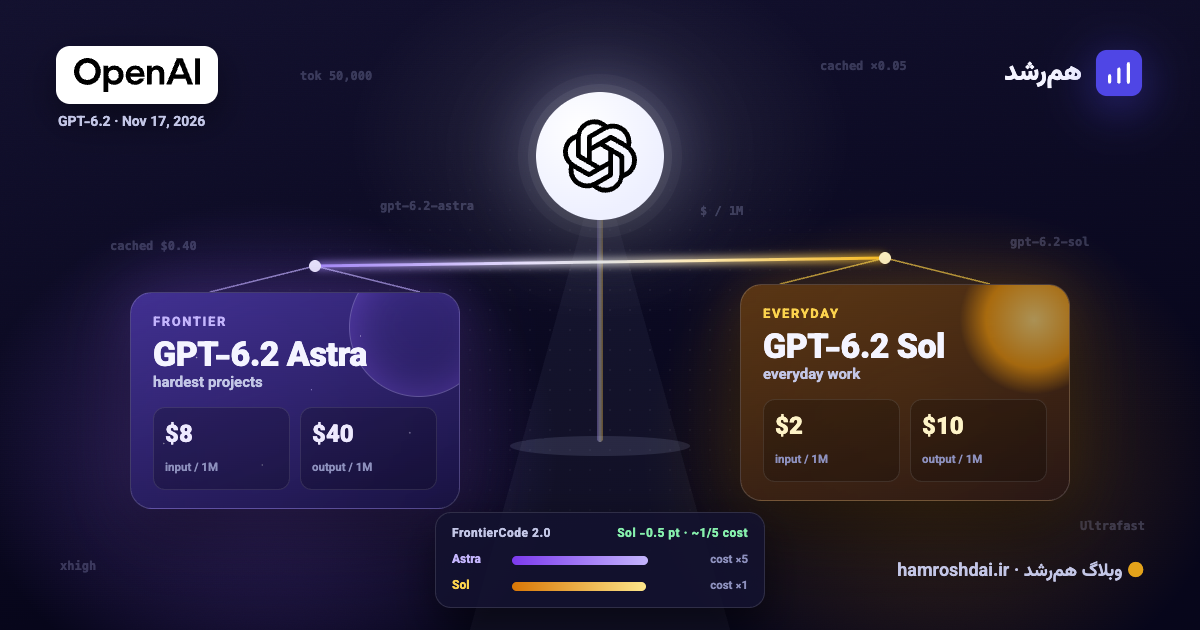
OpenAI دو مدل GPT-6.2 Astra و Sol را با فاصلهٔ قیمت ۴ برابری عرضه کرد. قیمتها، بنچمارکهای رسمی و مستقل، گلایههای اولیه و یک نقشهٔ عملی برای انتخاب مدل.
Siri AI برای همهٔ توسعهدهندگان باز شد؛ اپلیکیشن شما برای دستیارها آماده است؟
اپل در ۳ نوامبر Siri AI را به روی همهٔ اپلیکیشنها باز کرد، اما انتشار در App Store تا بهار صبر میخواهد. این سازوکار چطور کار میکند و تیمهای محصول از همین حالا چه کنند؟