Qwen4-Max آمد اما وزنهایش بسته است؛ API بگیریم یا مدل متنوزن مثل Mistral Large 4؟
علیبابا Qwen4-Max را با ۲٫۴ تریلیون پارامتر، پنجرهٔ یک میلیون توکنی و API ارزانتر عرضه کرد، اما وزنهایش را منتشر نکرد. مقایسه با Mistral Large 4 متنوزن و چهار سؤال برای انتخاب.
علیبابا روز ۱۶ نوامبر ۲۰۲۶ (۲۵ آبان ۱۴۰۵) مدل Qwen4-Max را برای همه در دسترس گذاشت. این بزرگترین و تواناترین مدل خانوادهٔ Qwen تا امروز است و استفاده از آن از نسل قبل ارزانتر شده است. اما یک تفاوت مهم دارد: وزنهایش منتشر نشده است. برای خانوادهای که پایهٔ هزاران مدل بازتنظیمشدهٔ جامعهٔ متنباز بوده، این نکته به اندازهٔ هر بنچمارکی اهمیت دارد.
دو هفته و نیم پیش از آن، Mistral مسیر برعکس را رفت و وزنهای Mistral Large 4 را منتشر کرد؛ مدلی با جاهطلبی مشابه. پس تیمی که این ماه دنبال یک مدل بزرگ است، واقعاً سر یک دوراهی ایستاده: یک مدل پیشرو را از طریق API اجاره کند، یا مدلی را دانلود کند و خودش اجرا کند. این مقاله توضیح میدهد هر کدام از این دو عرضه واقعاً چه چیزی میدهند و چطور میشود بینشان تصمیم گرفت.
علیبابا دقیقاً چه چیزی عرضه کرد؟
طبق اطلاعیهٔ علیبابا، Qwen4-Max یک مدل «ترکیب متخصصها» (Mixture-of-Experts یا MoE) با ۲٫۴ تریلیون پارامتر است که برای هر توکن فقط ۷۱ میلیارد پارامترش فعال میشود. تصویر را بهصورت بومی میفهمد و تا یک میلیون توکن ورودی میپذیرد؛ یعنی یک مخزن کد بزرگ یا انبوهی از قراردادها در یک درخواست جا میشود.
ادعاهای اصلی:
بهرهوری. در Work360، بنچمارک اختصاصی علیبابا با کارهایی از ۷۲۱ حوزهٔ تخصصی، Qwen4-Max از Qwen3.8-Max بهتر عمل کرده و در حالت استدلال پرتلاش ۳۵٪ توکن کمتری مصرف کرده است. TechNode گزارش داده که میانگین هزینهٔ هر کار در این بنچمارک از ۲۶٫۵۸ یوان به ۱۱٫۱۶ یوان رسیده؛ حدود ۵۸٪ کمتر.
پارامتر فعال کمتر. به نوشتهٔ Decrypt، این مدل برای هر توکن ۷۱ میلیارد پارامتر فعال میکند، در برابر ۹۵ میلیارد در Qwen3.8-Max؛ پس مدلی بسیار بزرگ، برای هر توکن محاسبهٔ کمتری لازم دارد.
رتبهبندی. علیبابا میگوید مدل در Code Arena، جدولی که بر پایهٔ رأی کاربران به وبسایتهای ساختهشده با هوش مصنوعی است، رتبهٔ ششم را گرفته است.
عاملهای طولانیمدت. نمونههای علیبابا شامل اجرای ۴۸ساعته و چهارمرحلهای یک عامل در پژوهش شیمی و نمایشی صنعتی است که زمان برنامهنویسی ساخت یک قطعه را از حدود ۴۷۵ دقیقه به ۲۴ دقیقه رسانده است.
این نمونهها را خود علیبابا انتخاب کرده و آزمون مستقل نیستند؛ Work360 هم بنچمارکی اختصاصی است. تا وقتی ارزیابی خودتان آنها را تأیید نکرده، این عددها را ادعای سازنده بدانید.
قیمت، دسترسی و محدودیت وزنهای بسته
Qwen4-Max از طریق QwenCloud (API و Token Plan) و در اپهای خود علیبابا، یعنی QwenWork و Qwen Studio، در دسترس است. Decrypt قیمت API را ۱٫۵ دلار برای هر میلیون توکن ورودی و ۴٫۵ دلار برای هر میلیون توکن خروجی گزارش کرده؛ ۲۵٪ کمتر از ۲ و ۶ دلارِ مدل پرچمدار قبلی. ورودی تکراری که از حافظهٔ نهان خودکار خوانده شود، هر میلیون توکن ۰٫۰۷۵ دلار است؛ یعنی کارهایی که یک متن طولانی را بارها میفرستند، بسیار ارزانتر میشوند.
محدودیت اصلی این است که وزنها منتشر نشدهاند. نمیتوانید مدل را دانلود کنید، روی سختافزار خودتان بازتنظیمش کنید یا در شبکهٔ خصوصی اجرایش کنید. این تغییر لحن قابل توجهی است: Decrypt به شمارش Hugging Face اشاره میکند که ۱۵۱٬۴۴۸ مدل مشتقشده از Qwen را نشان میدهد، و علیبابا وزنهای Qwen3.8-Max را منتشر کرده بود. شرکت میگوید مدلهای کوچکترِ متنوزن Qwen4 «بهزودی» منتشر میشوند، اما اندازه یا تاریخی اعلام نکرده است.
گزینهٔ متنوزن: Mistral Large 4
Mistral وزنهای Mistral Large 4 را روز ۲۹ اکتبر ۲۰۲۶، بعد از یک دورهٔ پیشنمایش فقط از طریق API، منتشر کرد. کارت مدل در Hugging Face این مشخصات را میدهد:
حدود ۱ تریلیون پارامتر کل و ۴۹ میلیارد پارامتر فعال برای هر توکن (۵۲ میلیارد با لایههای embedding و خروجی)، با ۱۲۸ متخصص که ۴ تا در هر توکن فعالاند، بهعلاوهٔ یک متخصص مشترک.
ورودی تصویر بهصورت بومی، پنجرهٔ ورودی یک میلیون توکنی و تسلط بر بیش از ۱۶۰ زبان.
سه سطح استدلال (کم، متوسط و زیاد)، تا در هر درخواست بین عمق و هزینه تعادل برقرار کنید.
اجرای پیشنهادی با vLLM یا SGLang، و یک نسخهٔ NVFP4 با حافظهٔ کمتر برای پردازندههای گرافیکی Blackwell انویدیا.
مجوز آن Mistral Ecosystem Open-Weight License است؛ نسخهٔ تغییریافتهٔ مجوز MIT. استفاده، تغییر، بازتنظیم و استفادهٔ تجاری آزاد است. تنها شرط این است که کسبوکاری که خودِ مدل را بهعنوان سرویس میفروشد (Model-as-a-Service) باید مجوز تجاری جداگانه از Mistral بگیرد. Mistral همچنین میگوید Large 4 با ۴۱٪ در Terminal-Bench 4.0 در میان مدلهای متنوزن اول است و در شاخص Coding Agent سایت Artificial Analysis امتیاز ۴۸٪ گرفته است. این عددها هم مثل عددهای علیبابا، گزارش خود سازندهاند.
مقایسهٔ کنار هم
Qwen4-Max | Mistral Large 4 | |
|---|---|---|
تاریخ عرضه | ۱۶ نوامبر ۲۰۲۶ | انتشار وزنها ۲۹ اکتبر ۲۰۲۶ |
پارامتر کل / فعال | ۲٫۴ تریلیون / ۷۱ میلیارد | حدود ۱ تریلیون / ۴۹ میلیارد (۵۲ با embedding) |
پنجرهٔ ورودی | ۱ میلیون توکن | ۱ میلیون توکن |
ورودی تصویر | دارد | دارد |
وزنها | بسته (فقط API و اپها) | باز، با مجوز Mistral Ecosystem |
روش اجرا | API در QwenCloud، QwenWork، Qwen Studio | GPUهای خودتان (vLLM/SGLang) یا میزبان مدیریتشده |
قیمت اعلامشدهٔ API | ۱٫۵ دلار ورودی / ۴٫۵ دلار خروجی برای هر میلیون توکن | بسته به محل میزبانی |
تیم شما کدام را انتخاب کند؟
جواب درست بیشتر به چهار سؤال عملی بستگی دارد تا به جدول رتبهبندی.
۱. دادههایتان اجازه دارند کجا بروند؟ اگر قراردادها، اطلاعات مشتری یا کد منبع نباید از شبکهٔ شما خارج شوند، مدلی که فقط از طریق API در دسترس است، هر قدر هم خوب باشد، از همان ابتدا کنار میرود. وزنهای باز تنها راه اجرای مدلی در این رده بهطور کامل در زیرساخت خودتان است.
۲. واقعاً سختافزارش را دارید؟ اجرای مدل متنوزن رایگان نیست. با دقت ۴ بیتی، یک تریلیون پارامتر یعنی حدود ۵۰۰ گیگابایت فقط برای وزنها، پیش از حافظهای که ورودیهای طولانی لازم دارند. نمونههای اجرای خود کارت مدل یک سرور چندGPUیی را فرض میکنند و ۸ GPU را مثال میزنند. اگر چنین سختافزاری ندارید یا نمیتوانید اجارهاش کنید، API گزینهٔ واقعبینانه است.
۳. هزینهٔ یک کارِ تمامشده چقدر است؟ هزینهٔ هر کار انجامشده را مقایسه کنید، نه قیمت هر توکن. استدلال علیبابا برای Qwen4-Max دقیقاً همین است: توکن کمتر برای هر کار و ورودی ارزانِ کششده. در مدلی که خودتان میزبانی میکنید، هزینه زمان GPU و ساعتهای مهندسی است که فقط در حجم بالا و پایدار بهصرفه میشود.
۴. چقدر وابستگی را میپذیرید؟ در API، سازنده میتواند قیمت، محدودیت نرخ یا خودِ مدل را تغییر دهد. با وزنهای باز، نسخهای ثابت در دست دارید که کسی نمیتواند پسش بگیرد، اما بهروزرسانی، وصلههای امنیتی و پایش هم با خودتان است.
این هفته چه کنیم؟
یک مجموعهٔ آزمون کوچک از کار واقعی بسازید. ۲۰ تا ۵۰ کار که تیمتان واقعاً انجام میدهد (خلاصهنویسی، بازبینی کد، استخراج اطلاعات از اسناد) را همراه با نمونهٔ جواب خوب جمع کنید.
هر دو نوع مدل را روی آن اجرا کنید. نتیجهها را خودتان امتیاز بدهید، از جمله به فارسی یا عربی اگر زبان کارتان است؛ بنچمارکهای سازندهها بهندرت این زبانها را پوشش میدهند.
هزینهٔ هر کار تمامشده را بسنجید، با احتساب تکرارها و اصلاحهای انسانی.
اول قواعد دادههایتان را بنویسید. اگر چیزی نباید از سرورهایتان خارج شود، این تصمیم پیش از هر مقایسهای گرفته میشود.
منتظر مدلهای کوچکترِ متنوزن Qwen4 باشید. اگر با کیفیت خوب و در اندازهای که میتوانید اجرا کنید منتشر شوند، ممکن است حساب بسیاری از تیمها را عوض کنند.
تحلیلهای بیشتر دربارهٔ مدلها و ابزارهای هوش مصنوعی را در وبلاگ همرشد بخوانید.
منابع
Alibaba Unveils Qwen4-Max: New AI Teammate for Work, Creativity, and Discovery (Alibaba Cloud، ۱۶ نوامبر ۲۰۲۶)
Alibaba launches Qwen4-Max with lower API prices and a million-token context window (TechNode، ۱۶ نوامبر ۲۰۲۶)
Alibaba's Qwen 4 Max Leads China's AI Agent Race—But You Can't Download It (Decrypt، ۱۶ نوامبر ۲۰۲۶)
Mistral Large 4 (Le Chonk) is now open weight (Mistral AI، ۲۹ اکتبر ۲۰۲۶)
کارت مدل mistralai/Mistral-Large-4-1T-A52B (Hugging Face)
تصویر: لوگوی Qwen (Alibaba Cloud / QwenLM، مجوز Apache 2.0) و لوگوی Mistral AI (مالکیت عمومی)، از Wikimedia Commons؛ نشانهای تجاری متعلق به صاحبانشان است.
مقالههای مرتبط
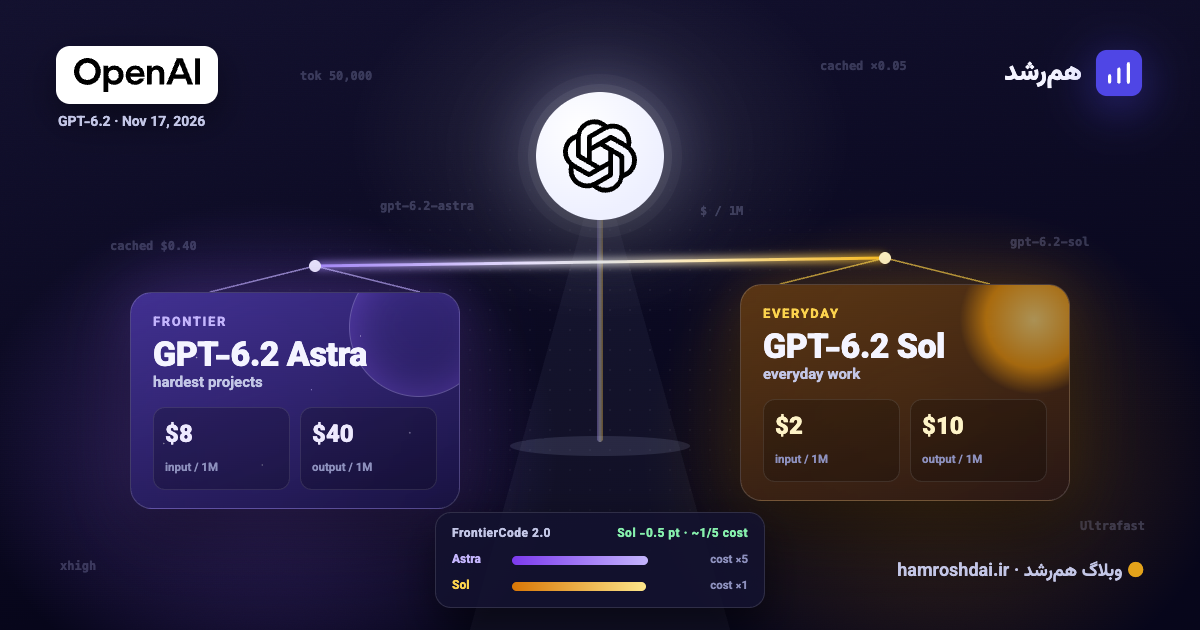
GPT-6.2 Astra یا Sol؛ کدام کار تیم را به کدام مدل تازهٔ OpenAI بسپاریم؟
OpenAI دو مدل GPT-6.2 Astra و Sol را با فاصلهٔ قیمت ۴ برابری عرضه کرد. قیمتها، بنچمارکهای رسمی و مستقل، گلایههای اولیه و یک نقشهٔ عملی برای انتخاب مدل.
Siri AI برای همهٔ توسعهدهندگان باز شد؛ اپلیکیشن شما برای دستیارها آماده است؟
اپل در ۳ نوامبر Siri AI را به روی همهٔ اپلیکیشنها باز کرد، اما انتشار در App Store تا بهار صبر میخواهد. این سازوکار چطور کار میکند و تیمهای محصول از همین حالا چه کنند؟
Gemini 4 Carbon و امنیت سایبری با هوش مصنوعی: چه چیزی تغییر کرد؟
گوگل مدل Gemini 4 Carbon را اول فقط به مدافعان سایبری داد و حالا برای همه باز کرده است. عددهایش چه میگویند و یک تیم کوچک چطور میتواند امن از آن استفاده کند؟